Converter PDF em word grátis online: Preservar a formatação
PDF Toucan editorial team · Atualizado em 20 de setembro de 2026 · 8 min de leitura
Para converter PDF em Word grátis online com boa preservação de formatação, comece por um PDF que tenha texto selecionável, transforme-o em DOCX e compare o resultado com o original antes de editar. Se o arquivo for um escaneamento, faça OCR primeiro para obter texto pesquisável e copiável; ainda assim, tabelas, fontes e quebras de página podem precisar de revisão manual.
Como converter PDF em Word grátis online no PDF Toucan?
O melhor ponto de partida é um PDF criado digitalmente, como relatórios, propostas, cartas ou documentos exportados de um editor. Um teste simples é tentar selecionar uma frase no leitor de PDF: se for possível marcar palavras individuais, o arquivo contém texto real.
Siga estes passos no PDF Toucan:
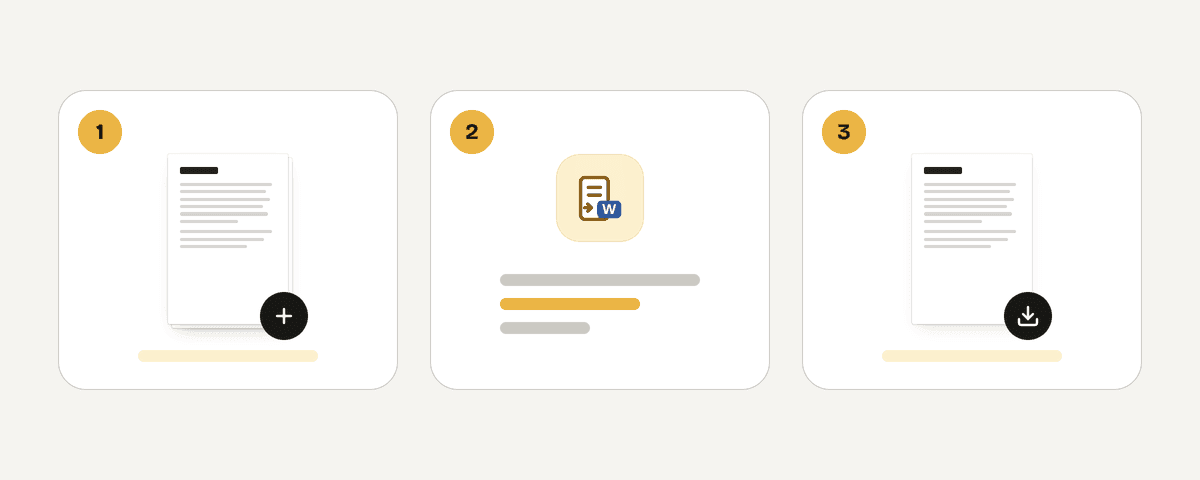
- Abra a ferramenta PDF para Word.
- Clique em “Selecionar arquivos PDF” e escolha o documento no computador ou celular. Também é possível arrastar e soltar o PDF em qualquer área da página ou colar um arquivo.
- Adicione um ou vários PDFs, se necessário. A ferramenta aceita conversões de múltiplos arquivos.
- Clique em “Converter para Word”.
- Quando o processamento terminar, clique em “Download the Word document” para baixar o arquivo DOCX.
- Abra o DOCX no Microsoft Word, Word para a Web, LibreOffice ou outro editor compatível. Faça uma revisão visual antes de alterar conteúdo ou compartilhar o documento.
A conversão não exige conta, não acrescenta marca-d’água e não tem limite diário nas ferramentas do navegador. Os anúncios ajudam a financiar o serviço. O arquivo é enviado por HTTPS para servidores na União Europeia, processado em memória, sem gravação em disco ou armazenamento, e apagado assim que o resultado é baixado, no máximo após 10 minutos.
Depois de editar o documento, você pode usar a ferramenta word-to-PDF do site se precisar voltar a um arquivo de layout fixo para envio ou arquivamento.
Por que o layout do PDF pode mudar ao converter para Word?
Não existe garantia de reprodução absolutamente idêntica, porque PDF e Word trabalham de maneiras diferentes. O PDF registra a posição fixa de letras, linhas, imagens e outros elementos na página. Já o Word reconstrói esse conteúdo como parágrafos, estilos, tabelas, margens, imagens ancoradas e quebras de seção editáveis.
Na conversão, o programa precisa deduzir qual estrutura gerou aquela página fixa. Em um contrato simples ou relatório de uma coluna, isso tende a funcionar bem. Em uma revista, catálogo ou formulário complexo, essa reconstrução pode ser apenas aproximada.
Os fatores mais comuns que causam diferenças são:
- Substituição de fontes: se a fonte usada no PDF não estiver disponível no dispositivo, o Word pode usar outra. Uma pequena mudança na largura dos caracteres altera quebras de linha e, em sequência, o número de páginas.
- Espaçamento e margens: PDF e Word podem calcular altura de linha, recuos e espaços entre parágrafos de formas diferentes.
- Colunas e caixas de texto: um layout editorial pode virar textos separados, caixas flutuantes ou uma sequência de conteúdo em uma única coluna.
- Imagens e objetos sobrepostos: figuras, legendas, setas e textos ao redor de imagens podem mudar de posição ou de comportamento.
- Cabeçalhos e rodapés: elementos fixos na página podem não se tornar automaticamente cabeçalhos e rodapés editáveis do Word.
Mantenha o PDF original intacto e trate o DOCX como cópia de trabalho. Antes de editar muito, confira a primeira e a última página, títulos, listas, cabeçalhos, rodapés, imagens e páginas com tabelas. Se a aparência idêntica for essencial, preserve também o PDF original como versão de referência.
PDF escaneado vira texto editável no Word?
Nem todo PDF contém texto digital. Um documento digitalizado por scanner, fotografado ou salvo como imagem geralmente contém uma imagem inteira para cada página. Mesmo que você veja letras na tela, elas podem não ser caracteres editáveis.
Faça este teste:
- Abra o PDF em um leitor.
- Tente selecionar uma frase, palavra por palavra.
- Copie e cole essa frase em um editor de texto.
- Se nada for selecionado, se for selecionada a página inteira como um bloco ou se o texto colado vier vazio ou ilegível, considere o PDF um escaneamento.
Na ferramenta PDF para Word, páginas escaneadas não são transformadas em texto. Elas são adicionadas ao documento Word como imagens. Isso pode conservar a aparência visual da página, mas não permite clicar em um parágrafo e corrigir uma palavra como texto normal.
A comparação abaixo ajuda a escolher o fluxo correto:
| Tipo de PDF | Resultado direto em Word | Melhor ação |
|---|---|---|
| PDF digital com texto selecionável | Texto e estrutura geralmente editáveis | Converter e revisar o DOCX |
| PDF misto, com texto e páginas escaneadas | Partes digitais editáveis; scans podem virar imagens | Aplicar OCR às páginas necessárias |
| Scan limpo de documento impresso | Aparência preservada, mas texto não editável diretamente | Executar OCR antes de trabalhar no texto |
| Scan borrado, torto ou com manuscrito | Maior risco de erros | OCR, conferência intensa e possível redigitação |
Como usar OCR em um PDF escaneado antes de trabalhar no conteúdo?
OCR é o reconhecimento óptico de caracteres. Ele analisa a imagem de uma página e cria uma camada de texto que pode ser pesquisada e copiada. Isso não elimina a necessidade de revisão: nomes, valores, datas, códigos e acentos merecem conferência contra o original.
Para criar um PDF pesquisável no PDF Toucan:
- Abra a ferramenta OCR em PDF.
- Clique em “Selecionar arquivos PDF”. Você também pode arrastar, soltar ou colar o arquivo na página.
- Em “Document language”, escolha Português e somente os outros idiomas realmente presentes no documento. É preciso selecionar ao menos um idioma; opções extras deixam o reconhecimento mais lento.
- Em “Which pages should be scanned?”, prefira “Scan pages without text”. Essa é a opção recomendada, pois preserva as páginas que já têm texto selecionável.
- Use “Recognize existing text again” apenas quando um OCR anterior estiver claramente ruim. Essa opção remove o texto antigo reconhecido e lê novamente as páginas.
- Evite “Treat every page as an image” salvo quando for indispensável. Essa configuração transforma todas as páginas em imagem para uma nova leitura e remove texto selecionável e links existentes.
- Em “Page fixes”, ative “Straighten tilted pages” se houver páginas tortas. Use “Fix page orientation automatically” para folhas de lado ou de cabeça para baixo. O endireitamento não está disponível ao usar o reconhecimento de texto existente novamente.
- Clique em “Reconhecer texto”.
- Ao terminar, clique em “Download the searchable PDF”.
O reconhecimento pode levar alguns minutos em arquivos com muitas páginas. O PDF gerado serve para pesquisar e copiar texto. Depois, você pode passá-lo pela conversão para Word, mas, em escaneamentos, ainda pode ser necessário copiar o conteúdo reconhecido para o Word e reconstruir manualmente partes do layout.
Como revisar tabelas, fontes e dados depois da conversão?
A forma mais eficiente de revisar é abrir o PDF e o DOCX lado a lado. Corrija primeiro a estrutura geral e só depois os detalhes visuais. Alterar fontes antes de configurar a página, por exemplo, pode criar novas quebras e obrigar a refazer o trabalho.
Use esta sequência:
- Confira a configuração da página. Compare orientação, tamanho do papel, margens e páginas em branco. Ajustes aqui podem corrigir várias quebras de uma vez.
- Revise as fontes. Procure títulos com linhas quebradas em lugares estranhos, parágrafos que aumentaram de altura e caracteres substituídos. Escolha fontes disponíveis para todos que precisarão abrir o arquivo.
- Valide tabelas. Verifique largura das colunas, linhas divididas entre páginas, células mescladas, alinhamento de números e sinais negativos. Em documentos financeiros, confirme vírgulas, casas decimais, datas e totais.
- Reconstrua tabelas problemáticas. Se houver muitas células desalinhadas, normalmente é mais rápido criar uma nova tabela em Inserir > Tabela no Word e preencher os dados revisados.
- Corrija cabeçalhos, rodapés e numeração. Se esses itens vierem como caixas de texto comuns, recrie-os com os recursos próprios de cabeçalho e rodapé do Word.
- Revise listas e colunas. Marcadores podem ser caracteres comuns, não listas automáticas. Reaplique estilos de lista para que a numeração funcione corretamente.
- Inspecione imagens e legendas. Confira objetos flutuantes, textos ao lado de figuras e elementos sobrepostos.
Em documentos longos ou de layout complexo, faça a revisão final em um computador. No celular, é mais difícil perceber diferenças de margens, tabulações, cabeçalhos e posições de imagens.
Quando devo esperar um resultado imperfeito?
Alguns arquivos exigem ajustes mesmo após uma conversão bem-sucedida. Quanto mais o documento depender de design visual, mais difícil será convertê-lo em conteúdo editável mantendo a mesma aparência.
Espere mais trabalho nos casos abaixo:
- Scans com baixa resolução, sombras, manchas, páginas inclinadas ou letras pequenas.
- Manuscritos, anotações à mão, carimbos sobre o texto e assinaturas desenhadas.
- Revistas, folhetos, catálogos e PDFs com muitas colunas ou elementos decorativos.
- Tabelas sem bordas, fórmulas, diagramas, gráficos e desenhos técnicos.
- Formulários com campos interativos, pois o comportamento desses campos pode não ser preservado no Word.
- Fontes decorativas ou incorporadas no PDF, mas indisponíveis no computador de edição.
O OCR pode confundir caracteres parecidos, como O e 0, l e 1, além de errar acentos ou números em tabelas densas. Para documentos jurídicos, bancários, médicos ou acadêmicos, compare cada trecho crítico com o PDF original antes de considerar o Word como versão final.
Há também uma atenção importante para arquivos assinados digitalmente: depois do OCR, a assinatura digital deixa de ser válida, pois o conteúdo do PDF foi alterado. Arquive o PDF assinado original e use a versão reconhecida apenas como cópia de trabalho pesquisável.
Perguntas frequentes
O PDF para Word mantém exatamente a mesma formatação?
Nem sempre. O PDF fixa elementos em coordenadas, enquanto o Word recria o conteúdo como itens editáveis. Fontes substituídas, margens, espaçamento, colunas, tabelas e imagens podem deslocar linhas e páginas. Revise o DOCX lado a lado com o original antes de distribuir a versão editada.
Como saber se meu PDF é escaneado ou tem texto selecionável?
Tente selecionar uma frase e copiá-la para um editor de texto. Se palavras individuais forem selecionadas e o texto for colado corretamente, o PDF tem texto digital. Se a página inteira for tratada como imagem ou nada puder ser copiado, provavelmente é um escaneamento.
Posso transformar um PDF escaneado em Word editável?
Primeiro use OCR para criar um PDF pesquisável e copiável. Depois, converta esse PDF para Word e revise o resultado. Ainda pode ser necessário colar o texto no Word e reconstruir tabelas, listas ou colunas, porque o OCR reconhece caracteres, mas não reproduz perfeitamente todo o design.
O OCR corrige páginas tortas ou viradas?
Sim, há opções para isso. Ative “Straighten tilted pages” para páginas inclinadas e “Fix page orientation automatically” para páginas de lado ou invertidas. O endireitamento não fica disponível quando você escolhe reconhecer novamente um texto existente no PDF.
A conversão de PDF para Word é grátis e sem marca-d’água?
Sim. No PDF Toucan, a ferramenta não exige conta, não adiciona marca-d’água e não estabelece limite diário para as ferramentas usadas no navegador. Os arquivos são enviados por HTTPS, processados em memória na União Europeia e apagados após o download, no máximo em 10 minutos.
Guias relacionados
- OCR PDF online gratuito: Deixe documentos escaneados pesquisáveisAprenda a reconhecer texto em PDFs escaneados, escolher idiomas, corrigir páginas tortas, conferir o OCR e converter para Word quando necessário.8 min de leitura
- Ilovepdf ou smallpdf: Limites grátis, privacidade e alternativasCompare limites, tamanho de arquivo, marcas-d’água, idiomas e privacidade do iLovePDF e Smallpdf — e veja onde o PDF Toucan difere.6 min de leitura