PDF naar word converteren: Opmaak zo goed mogelijk behouden
PDF Toucan editorial team · Laatst bijgewerkt op 20 september 2026 · 8 min leestijd
Je kunt een PDF naar Word converteren met een goed bewerkbaar resultaat als de PDF digitaal is gemaakt en tekst bevat die je kunt selecteren. Een volledig identieke opmaak is niet altijd haalbaar: Word moet een vaste PDF-pagina opnieuw opbouwen uit alinea’s, tabellen en afbeeldingen. Gebruik bij scans eerst OCR, vergelijk het DOCX-bestand altijd met de originele PDF en herstel pas daarna de afwijkingen.
Waarom verandert de opmaak als je een PDF naar Word converteert?
Een PDF is gemaakt om er overal hetzelfde uit te zien. Tekst, lijnen, afbeeldingen en andere onderdelen staan op vaste posities op de pagina. Een Word-document werkt anders: het bevat bewerkbare alinea’s, stijlen, marges, tabellen, secties en afbeeldingen die Word opnieuw positioneert zodra je het bestand opent.
Bij conversie moet die onderliggende structuur dus worden afgeleid uit de vaste paginaweergave. Dat lukt vaak goed bij een eenvoudige brief of rapport, maar is zelden helemaal één op één. Vooral deze onderdelen kunnen verschuiven:
- Lettertypen: als een lettertype niet beschikbaar is in Word of op jouw computer, wordt het vervangen. Daardoor wijzigen tekenbreedtes, regelafbrekingen en soms ook het aantal pagina’s.
- Kolommen en tekstvakken: een brochure met meerdere kolommen kan in Word uit losse tekstvakken bestaan, of juist als één lange tekstkolom verschijnen.
- Afbeeldingen: een afbeelding die exact op een PDF-pagina stond, wordt in Word een zwevend of in de tekst geplaatst object. Bijschriften en tekstomloop kunnen dan verschuiven.
- Kop- en voetteksten: deze komen soms niet als echte Word-koptekst of -voettekst terug en vragen dan om handmatig herstel.
- Voetnoten, formulieren en lagen: interactieve velden, links en meerdere tekstlagen zijn niet altijd op dezelfde manier bewerkbaar in Word.
Houd de originele PDF daarom altijd open als referentie. Pas het geconverteerde DOCX-bestand aan, maar overschrijf de bron-PDF niet.
Hoe kun je een gewone PDF naar Word converteren?
Een digitaal gemaakte PDF met selecteerbare tekst geeft de beste uitgangspositie. Test dit vooraf door in de PDF een woord te selecteren. Kun je losse woorden markeren en kopiëren, dan bevat het bestand waarschijnlijk echte tekst in plaats van alleen pagina-afbeeldingen.
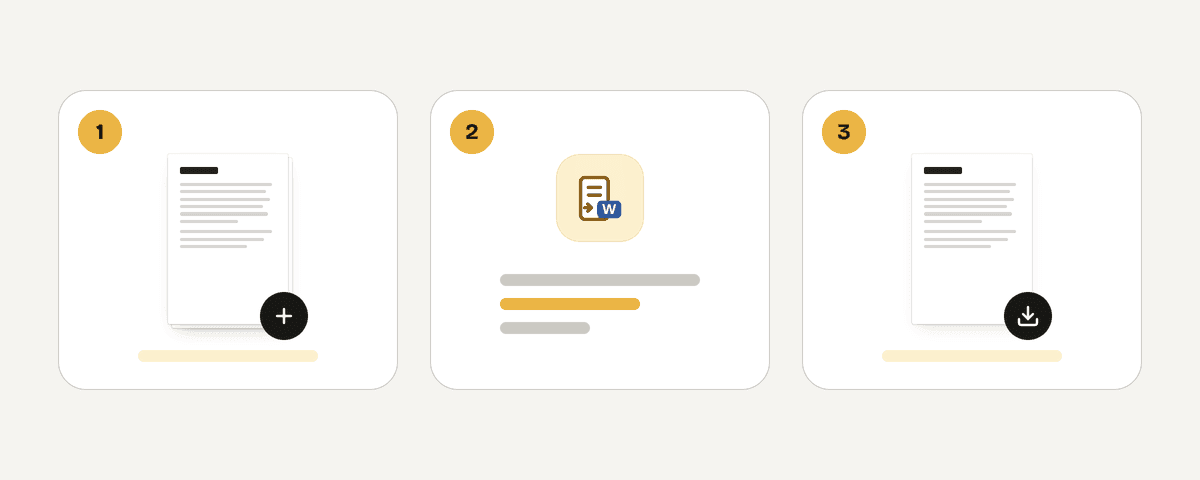
- Open de PDF naar Word-tool van PDF Toucan.
- Klik op “PDF-bestanden selecteren”.
- Kies één of meer PDF-bestanden. Je kunt bestanden ook ergens op de pagina neerzetten of ze vanaf het klembord plakken.
- Controleer of je de juiste bestanden hebt toegevoegd onder de bestanden die naar Word worden omgezet.
- Klik op “Converteren naar Word”.
- Wacht tot de documenten gereed zijn en kies “Download het Word-document”.
- Open het gedownloade DOCX-bestand in Microsoft Word op Windows of Mac. Vergelijk eerst de opmaak met de originele PDF voordat je inhoudelijke wijzigingen doet.
De browsertool is gratis te gebruiken, zonder account, watermerk of dagelijkse limiet; advertenties financieren de site. Bestanden worden via HTTPS naar servers in de Europese Unie gestuurd, in het geheugen verwerkt en niet op schijf opgeslagen. Na het downloaden wordt het resultaat verwijderd, uiterlijk binnen 10 minuten.
Wat doe je als de PDF een scan is en geen selecteerbare tekst heeft?
Een scan is meestal een afbeelding van elke pagina. Als je bij selectie alleen een groot vlak rond de pagina krijgt, in plaats van afzonderlijke woorden, is dat een belangrijk verschil. De PDF naar Word-tool maakt gescande pagina’s niet om tot bewerkbare tekst: ze worden als afbeeldingen in het Word-document geplaatst.
Wil je tekst kunnen zoeken, kopiëren en vervolgens beter naar Word overbrengen, voer dan eerst tekstherkenning uit met OCR PDF.
- Open de OCR-tool en klik op “PDF-bestanden selecteren”. Neerzetten of plakken op de pagina kan ook.
- Kies bij “Document language” de taal of talen die werkelijk in het document staan. Selecteer niet onnodig veel talen: extra talen vertragen de herkenning.
- Open “More options” om het bereik en de herkenningswijze te controleren.
- Kies bij voorkeur “Scan pages without text”. Dit is de aanbevolen instelling: pagina’s die al digitale tekst bevatten, blijven ongemoeid.
- Kies “Recognize existing text again” alleen als een bestaande tekstlaag duidelijk slecht is herkend. De oude herkenning wordt dan verwijderd en opnieuw gelezen.
- Gebruik “Treat every page as an image” alleen als laatste redmiddel. Daarbij gaan bestaande selecteerbare tekst en links verloren.
- Schakel bij scheve pagina’s “Straighten tilted pages” in. Gebruik “Fix page orientation automatically” voor pagina’s die gedraaid, liggend of ondersteboven zijn gescand.
- Klik op “Tekst herkennen” en download daarna de doorzoekbare PDF.
OCR maakt tekst doorzoekbaar en kopieerbaar, maar garandeert geen foutloze herkenning en geen identieke Word-opmaak. Lange documenten kunnen enkele minuten kosten. Let ook op digitale handtekeningen: na tekstherkenning is een digitale handtekening niet langer geldig. Bewaar het oorspronkelijk ondertekende bestand daarom afzonderlijk.
Hoe krijg je tabellen zo bruikbaar mogelijk in Word?
Tabellen vragen vaak het meeste herstelwerk. Een eenvoudige tabel met zichtbare randen, korte celinhoud en één regel tekst per cel komt doorgaans beter over dan een tabel met samengevoegde cellen, verticale tekst, geneste tabellen of veel notities in dezelfde cel.
Controleer na conversie deze punten, in deze volgorde:
- Kolombreedtes: kijk of tekst buiten de cel valt en of bedragen of datums zijn afgebroken.
- Samengevoegde cellen: controleer kopregels, subtotalen en cellen die over meerdere kolommen lopen.
- Getallen: vergelijk decimalen, mintekens, valuta, datums en totalen met de bron-PDF.
- Rij-einden: kijk of een rij onwenselijk over twee pagina’s is verdeeld.
- Uitlijning: herstel links-, rechts- en middenuitlijning met de tabelhulpmiddelen van Word, niet met reeksen spaties.
Als een tabel op veel plaatsen kapot is, is opnieuw opbouwen als echte Word-tabel vaak sneller en betrouwbaarder dan losse tekst corrigeren. Bij een gescande tabel kan OCR vooral problemen hebben met komma’s, punten, mintekens en celgrenzen. Vergelijk financiële, medische en technische gegevens daarom cel voor cel.
| Soort bronbestand | Verwacht resultaat | Wat je vooral controleert |
|---|---|---|
| Digitale PDF, één tekstkolom | Goed | Lettertypen en pagina-einden |
| Rapport met eenvoudige tabellen | Redelijk goed | Kolombreedtes en rijen |
| PDF met meerdere kolommen | Wisselend | Tekstvakken, leesvolgorde en koppen |
| Schone scan met OCR | Tekst vaak bruikbaar, opmaak benaderend | Namen, cijfers en tekens |
| Lage-resolutiescan of scheve kopie | Beperkt | Veel handmatige correctie |
| Brochure met veel vormgeving | Beperkt | Afbeeldingen, kaders en kolommen |
| Handschrift | Niet geschikt als betrouwbare tekst | Behoud als afbeelding |
Welke bestanden leveren de beste resultaten op?
De beste kans op behoud van opmaak heb je met een digitaal gemaakte PDF met standaardlettertypen, duidelijke alinea’s en een eenvoudige pagina-indeling. Denk aan een offerte, brief, contract of verslag dat vanuit een tekstverwerker naar PDF is geëxporteerd.
Meer herstelwerk is normaal bij oude kopieën, scans met schaduwen of vouwen, lage resolutie, gekleurde achtergronden, handschrift en grafische tekst. Ook bedrijfslettertypen die niet zijn ingesloten of niet op jouw systeem staan, veroorzaken afwijkende regelafbrekingen. Een beveiligde PDF, formulier met invulvelden of zwaar ontworpen brochure kan niet altijd volledig gelijk worden aan het origineel.
Converteer daarom vooral als je de inhoud echt wilt aanpassen. Is een document alleen bedoeld om te lezen, te archiveren of precies zo te printen, dan blijft de originele PDF vaak de beste versie.
Hoe controleer en herstel je het Word-bestand na de conversie?
Werk eerst aan structuur en daarna pas aan details. Zo voorkom je dat je posities corrigeert die later opnieuw verschuiven door een ander lettertype of gewijzigde marge.
- Open de PDF en het DOCX-bestand naast elkaar. Op Windows kun je twee vensters naast elkaar vastzetten; op Mac kun je Split View gebruiken.
- Controleer eerst papierformaat, afdrukstand, marges en totale paginering.
- Vergelijk per pagina titels, alinea-einden, kop- en voetteksten, afbeeldingen, opsommingen en paginanummers.
- Open in Word het “Navigatievenster”. Kijk of belangrijke titels als echte koppen zijn herkend. Pas waar nodig kopstijlen toe in plaats van elk opschrift handmatig op te maken.
- Controleer tabellen voordat je de rest van de tekst verfijnt.
- Gebruik “Zoeken” voor namen, bedragen, meetwaarden, accenten en referentienummers. Bij OCR controleer je extra op verwisselingen zoals O en 0, of l en 1.
- Sla het herstelde bestand op als DOCX-kopie. Heb je weer een vaste, niet-meeschalende eindversie nodig, dan kun je die met word-to-PDF opnieuw als PDF maken.
Veelgestelde vragen
Kan ik een PDF naar Word converteren zonder account?
Ja. PDF Toucan vraagt geen account voor de PDF naar Word-tool, plaatst geen watermerk en hanteert geen dagelijkse limiet voor de browsertools. Bestanden worden via HTTPS verwerkt op servers in de Europese Unie, in het geheugen verwerkt en uiterlijk 10 minuten na het downloaden verwijderd.
Waarom komt mijn gescande PDF als afbeelding in Word terecht?
Een scan bevat meestal alleen een afbeelding van een papieren pagina, geen afzonderlijke teksttekens. De PDF naar Word-tool zet zulke gescande pagina’s als afbeeldingen in het Word-document. Gebruik eerst OCR als je tekst wilt kunnen zoeken en kopiëren, en converteer de doorzoekbare PDF daarna naar Word.
Kan OCR een scan foutloos omzetten naar bewerkbare Word-tekst?
Nee. OCR kan tekst herkenbaar, doorzoekbaar en kopieerbaar maken, maar fouten blijven mogelijk bij wazige scans, klein lettertype, scheve pagina’s, handschrift en complexe tabellen. Controleer altijd namen, datums, bedragen, formules en tekens die op elkaar lijken voordat je de tekst gebruikt of doorstuurt.
Waarom zijn tabellen na het converteren verschoven?
Een PDF bewaart de visuele positie van tabelonderdelen, terwijl Word echte cellen, kolommen en rijen moet reconstrueren. Samengevoegde cellen, afgebroken regels, verticale tekst en onduidelijke randen maken dat lastiger. Controleer eerst breedtes, totalen en rij-einden; bouw een sterk beschadigde tabel liever opnieuw op.
Blijft mijn digitale handtekening geldig na OCR?
Nee. Tekstherkenning wijzigt de inhoud van de PDF, waardoor de digitale handtekening niet langer geldig is. Bewaar daarom altijd het originele ondertekende bestand wanneer de handtekening juridisch, administratief of voor een controle van belang is. Gebruik de OCR-versie uitsluitend als werk- of zoekkopie.
Gerelateerde gidsen
- PDF OCR online gratis: Maak een gescande PDF doorzoekbaarMaak een gescande pdf online doorzoekbaar met OCR. Kies de juiste taal, corrigeer scheve pagina’s en controleer de tekst vóór Word.9 min leestijd
- PDF samenvoegen gratis onbeperkt: ILovePDF, Smallpdf of ToucanVergelijk gratis PDF-limieten, bestandsgrootte, privacy, watermerken en talen van iLovePDF, Smallpdf en PDF Toucan.8 min leestijd