Maska text i PDF: Ta bort känsliga uppgifter på riktigt
PDF Toucan editorial team · Senast uppdaterad 20 september 2026 · 8 min läsning
För att maska text i PDF på ett säkert sätt måste uppgiften tas bort ur resultatfilen, inte bara döljas med en svart ruta. Med PDF Toucan kan du söka efter text, använda automatisk identifiering för vissa uppgiftstyper eller rita områden manuellt. Kontrollera alltid den färdiga PDF:en innan du delar den.
Varför räcker det inte att lägga en svart ruta över text i en PDF?
En PDF är ofta mer än en bild av en sida. Den kan innehålla text, bilder, teckensnitt och ritobjekt som separata delar. Om du lägger en svart rektangel ovanpå ett namn i ett rit- eller kommentarsverktyg kan originaltexten fortfarande finnas kvar under rutan.
Det innebär att mottagaren i vissa fall kan markera, kopiera, söka efter eller extrahera den dolda informationen. Samma problem kan uppstå om du gör texten vit, täcker den med en vit form eller beskär sidan. Beskärning ändrar ofta bara vad som visas, inte nödvändigtvis innehållet som ligger utanför sidans synliga yta.
En riktig maskning tar i stället bort de markerade uppgifterna ur resultatfilen. I Maskera PDF omvandlas de sidor som maskeras till bilder, vilket gör att den borttagna texten inte ligger kvar som valbar eller sökbar text på dessa sidor.
| Metod | Vad händer med originaluppgiften? | Lämplig att dela efter granskning? |
|---|---|---|
| Svart rektangel som kommentar | Kan ligga kvar under rutan | Nej |
| Vit text eller vit ruta | Kan ligga kvar i filen | Nej |
| Beskärning av sidan | Kan finnas kvar utanför den synliga ytan | Nej |
| Utskrift till ny PDF | Resultatet varierar mellan program | Osäkert |
| Riktig maskning | Den markerade uppgiften tas bort ur resultatet | Ja, efter kontroll |
Täck alltid hela den känsliga detaljen. Detta gäller inte bara ord och siffror, utan även signaturer, fotografier, QR-koder, streckkoder och delar av en logotyp som innehåller kontaktuppgifter.
Hur maskar jag text i PDF med PDF Toucan?
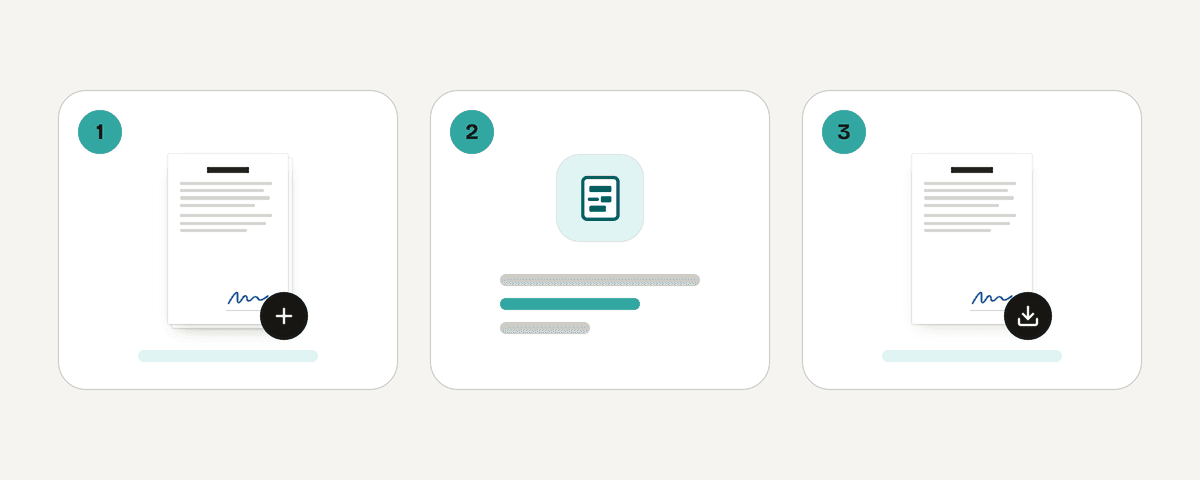
Följ stegen nedan för att maskera en PDF. Verktyget hanterar en PDF i taget och körs lokalt i webbläsaren. Filen laddas alltså inte upp till en server.
- Öppna verktyget för maskning och välj ”Välj PDF-fil”. Du kan även släppa PDF:en var som helst på sidan eller klistra in den.
- Vänta medan dokumentet öppnas. Om PDF:en innehåller sökbar text genomsöks sidorna.
- Leta upp återkommande text under ”Sök efter ord”. Skriv exempelvis ett förnamn, efternamn, företagsnamn eller kundnummer i fältet ”Ord att maskera” och välj ”Add”.
- Granska träffarna sida för sida. Ett namn kan förekomma i brödtext, sidhuvud, tabell, bilaga eller e-postsignatur och måste bedömas i sitt sammanhang.
- Markera sådant som inte kan hittas med textsökning genom att dra en ruta direkt över området på sidan. Du kan kombinera ordsökning och manuella rutor i samma dokument.
- Kontrollera listan ”Markerade områden”. Där kan du se var varje markering finns, visa den på sidan eller välja ”Ta bort markering: …” om något blev fel.
- Öppna ”More options” om du vill välja ”Box color” med svart eller vitt, eller rensa dokumentegenskaper.
- Välj ”Maskera” först när alla områden är kontrollerade.
Efter maskningen är de markerade detaljerna permanent borttagna ur resultatfilen. De berörda sidorna görs om till bilder. Det skyddar den borttagna texten från vanlig markering, kopiering och sökning, men innebär också att övrig text på dessa sidor inte längre är markerbar eller sökbar. Filstorleken kan dessutom förändras.
Vilka känsliga uppgifter kan hittas automatiskt?
Under ”Hitta automatiskt” finns hjälp för att leta efter vissa mönster i PDF:ens text. Funktionen kan hitta följande typer av uppgifter:
- Turkiskt ID-nummer
- IBAN
- E-postadress
- Telefonnummer
- Registreringsnummer
Detta är särskilt användbart i längre avtal, fakturor, rapporter och kundunderlag där samma typ av uppgift återkommer på många sidor. Automatisk sökning är dock bara ett stöd. Den kan missa information som är uppdelad med radbrytningar, skrivs med ovanliga avgränsare eller ligger i en bild.
Svenska personnummer, interna referensnummer och lokala format kan behöva hanteras på andra sätt. Sök då efter en specifik text, såsom hela numret eller ett namn, eller rita manuella rutor runt varje förekomst. Var också försiktig med korta sökord: ett efternamn kan ingå i ett annat ord och skapa oönskade träffar.
Gå igenom varje föreslagen markering innan du maskerar. Leta särskilt i följande delar av dokumentet:
- sidhuvuden och sidfötter
- tabeller och formulärfält
- bilagor och inskannade intyg
- kommentarer, stämplar och fritextfält
- företagslogotyper och e-postsignaturer
- foton, QR-koder och streckkoder
Hur maskerar jag skannade PDF:er, bilder och handskriven text?
En inskannad PDF består ofta av sidbilder utan något sökbart textlager. Då kan verktyget visa meddelandet att dokumentet saknar text och att automatisk sökning inte kan användas. Det är normalt för skanningar och innebär att du ska maskera varje berört område för hand.
- Öppna sidan och arbeta metodiskt från överkant till nederkant.
- Dra en ruta över varje uppgift som ska bort, till exempel ett personnummer, en adress, ett foto, en namnteckning eller en handskriven anteckning.
- Zooma in och kontrollera alla kanter. Rutan måste täcka hela uppgiften, även sista siffran, nedre delen av bokstäver och innehåll som fortsätter i en cell bredvid.
- Upprepa för samtliga sidor, även tomma baksidor, bilagor och formulärsidor där samma uppgift kan återkomma.
- Kontrollera ”Markerade områden” innan du väljer ”Maskera”.
På dator kan du flytta en vald ruta med piltangenterna. Ändra storlek med Alt tillsammans med piltangenterna, och ta bort en ruta med Delete. På mobil eller surfplatta ritar du med fingret. Växla mellan ”Scroll” och ”Draw area” vid behov så att sidan inte flyttas när du försöker markera.
Kom ihåg att automatisk textanalys inte kan läsa sådant som bara finns som pixlar i exempelvis en bild, en stämpel eller en fotograferad legitimation. Där krävs alltid visuell granskning och manuell markering.
Hur tar jag bort dokumentegenskaper och annan synlig information?
Maskning av sidinnehåll räcker inte alltid. En PDF kan också ha dokumentegenskaper med titel, författare, ämne och nyckelord. Om dessa uppgifter är känsliga öppnar du ”More options” och väljer ”Clear document details (title, author)”. Då rensas titel, författare, ämne och nyckelord från filegenskaperna i resultatet.
Dokumentegenskaper är inte samma sak som sidinnehåll. En e-postadress i en logotyp, ett namn i en fotnot eller ett telefonnummer i en QR-kod måste fortfarande maskeras direkt på sidan. Kontrollera även filnamnet innan du skickar dokumentet. Ett filnamn som innehåller kundnamn, ärendenummer eller personuppgifter kan avslöja information trots att själva PDF-sidan är korrekt maskerad.
Arbeta alltid på en kopia och behåll originalet separat. Det gör att du kan börja om om du råkar maskera för mycket, missar en uppgift eller behöver skapa en annan version för en annan mottagare.
Hur kontrollerar jag att texten verkligen är borttagen?
Granskningen efter maskning är avgörande. Öppna alltid resultatfilen i en vanlig PDF-läsare och inte bara i samma vy där du skapade markeringarna.
- Kontrollera visuellt varje sida, med extra fokus på alla markerade områden.
- Sök efter originaluppgifterna, exempelvis namn, e-postadress, IBAN, telefonnummer och delar av ett personnummer.
- Prova att markera och kopiera text nära de maskerade fälten. På de maskerade sidorna ska borttagen text inte kunna kopieras som vanlig text.
- Granska sidhuvuden, sidfötter, tabeller, bilagor och eventuella bilder en gång till.
- Kontrollera dokumentegenskaper om du har valt att rensa dem.
- Öppna gärna filen på den enhet där den ska delas, till exempel både dator och mobil. Då syns för små eller felplacerade rutor lättare.
Om PDF:en också ska skyddas under överföring eller arkivering kan du använda Skydda PDF efter maskningen. Välj ”Välj PDF-filer”, ange ett lösenord och välj ”Kryptera PDF:erna”. Lösenordet lämnar inte webbläsaren, och verktyget använder AES-256-kryptering.
Lösenordsskydd ersätter dock aldrig maskning. Kryptering bestämmer vem som kan öppna filen, medan maskning tar bort innehållet som mottagaren inte ska få. Den som har lösenordet kan fortfarande se all information som inte först har maskats. Spara lösenordet på ett säkert ställe, eftersom en borttappad lösenordsuppgift inte kan återställas av PDF Toucan.
Vanliga frågor
Kan jag maska ett svenskt personnummer i en PDF?
Ja. Sök efter hela personnumret under ”Sök efter ord” om det finns som text i PDF:en. Kontrollera varje träff och markera manuellt om numret finns i en skanning, bild eller tabell som inte kan sökas. Granska även personnumrets förekomst i bilagor och sidfötter.
Går det att maska text i en inskannad PDF?
Ja, men automatisk textsökning fungerar inte om skanningen saknar textlager. Dra då rutor manuellt över varje känslig uppgift på varje sida. Zooma in ordentligt och täck hela området, inklusive radbrytningar, handskrivna tillägg och delar som kan fortsätta i intilliggande tabellceller.
Är en svart ruta över text samma sak som att ta bort texten?
Nej. En svart ruta kan vara ett separat objekt ovanpå originaltexten. Texten under kan då ibland fortfarande sökas fram, kopieras eller extraheras. Riktig maskning tar bort den markerade informationen i resultatfilen, så att den inte bara är visuellt dold.
Kan jag lösenordsskydda en PDF i stället för att maska den?
Nej. Lösenordsskydd begränsar åtkomsten, men informationen finns fortfarande kvar i dokumentet för den som öppnar det. Maskera alltid uppgifter som mottagaren inte ska kunna se. Lägg sedan vid behov till lösenordsskydd på den redan granskade och maskerade kopian.