Конвертировать PDF в word без потери форматирования: Как
PDF Toucan editorial team · Обновлено 20 сентября 2026 г. · 9 мин. чтения
Чтобы конвертировать PDF в Word без потери форматирования, сначала определите тип исходника: цифровой PDF с выделяемым текстом можно сразу перевести в DOCX, а скан нужно предварительно распознать. После конвертации обязательно сравните таблицы, шрифты и разрывы страниц с оригиналом на компьютере, Android или iPhone.
Можно ли конвертировать PDF в Word без потери форматирования?
Полностью идентичный редактируемый документ получается не всегда. PDF и Word используют разные принципы вёрстки:
- PDF фиксирует положение букв, линий, изображений и других объектов на конкретной странице.
- DOCX хранит редактируемую структуру: абзацы, стили, таблицы, поля, колонки и привязки изображений.
- При преобразовании нужно восстановить эту структуру по готовому макету страницы.
Лучше всего обрабатываются цифровые PDF: документы, созданные в Word, Excel, программе для договоров или экспортированные из редактора. В них текст уже существует как текст, поэтому его проще преобразовать в абзацы и таблицы Word.
Даже у хорошего результата возможны небольшие различия: новые переносы строк, иной межстрочный интервал, сдвиг картинки, изменение нумерации или разрыв страницы в другом месте. Перед началом сохраните исходный PDF отдельно: он останется эталоном для проверки и поможет восстановить важный фрагмент.
Как определить: перед вами скан или обычный PDF?
От типа файла зависит порядок действий. Проведите быстрый тест:
- Откройте PDF в просмотрщике.
- Попробуйте мышью выделить одно предложение.
- Скопируйте его и вставьте в любой текстовый редактор.
- Проверьте результат.
Если слова выделяются по отдельности и вставляются читаемым текстом, перед вами обычный цифровой PDF. Его можно сразу отправить в конвертер.
Если выделяется вся страница как один объект, текст не выделяется вовсе либо при копировании появляются бессмысленные символы, это, вероятно, скан или файл с повреждённым текстовым слоем. При сильном увеличении у скана буквы обычно выглядят как часть изображения, а не как чёткие символы.
| Признак | Обычный PDF | Сканированный PDF |
|---|---|---|
| Выделение мышью | Выделяются слова и строки | Выделяется страница или ничего |
| Копирование | Вставляется читаемый текст | Вставляются ошибки или пустое содержимое |
| Следующий шаг | Сразу преобразование в DOCX | Сначала OCR, затем DOCX |
| Редактируемость после прямой конвертации | Обычно сохраняется | Страницы попадут в Word как картинки |
Как перевести обычный PDF в Word на PDF Toucan?
Если текст в документе выделяется, используйте инструмент PDF в Word. Он принимает один или несколько PDF и создаёт документы DOCX, которые можно открыть и редактировать в Word.
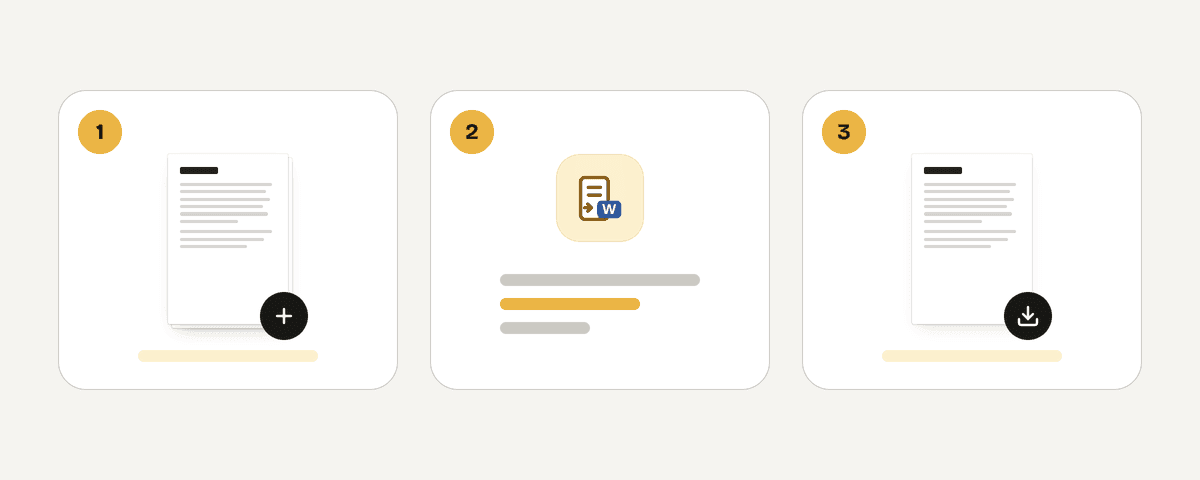
- Откройте страницу инструмента в браузере.
- Нажмите «Выбрать PDF-файлы» и укажите нужный документ.
- При необходимости добавьте несколько PDF. Файлы также можно перетащить в любое место страницы или вставить из буфера обмена.
- Нажмите «Преобразовать в Word».
- Когда обработка завершится, нажмите «Download the Word document».
- Откройте скачанный DOCX в Microsoft Word или другом редакторе с поддержкой формата DOCX.
Не начинайте сразу массовое редактирование. Сначала сопоставьте с оригиналом первую страницу, последнюю страницу, все страницы с таблицами, колонтитулы и места с изображениями. Так вы быстрее заметите системную проблему, например замену шрифта или неверные поля.
PDF Toucan не требует аккаунта, не добавляет водяные знаки и не устанавливает дневные лимиты для браузерных инструментов. Сервис финансируется рекламой.
Как конвертировать сканированный PDF в редактируемый Word?
Скан сначала нужно сделать текстовым с помощью OCR. Без распознавания инструмент преобразования не превращает сканированные страницы в редактируемый текст: они добавляются в DOCX как изображения.
Выполните распознавание через OCR PDF:
- Откройте инструмент и нажмите «Выбрать PDF-файлы».
- Добавьте скан. Его также можно перетащить на страницу или вставить из буфера обмена.
- В настройках языка документа выберите только языки, которые действительно есть в файле: например, русский и казахский либо русский и английский.
- Не добавляйте лишние языки «на всякий случай»: они замедляют распознавание. За один запуск можно объединить до пяти языков.
- Для типичного скана оставьте рекомендованный режим сканирования страниц без текста. Страницы, где текст уже есть, останутся без изменений.
- Для наклонённых листов включите выравнивание наклонённых страниц. Для перевёрнутых или боковых листов включите автоматическое исправление ориентации.
- Нажмите «Распознать текст» и дождитесь окончания процесса. Многостраничный файл может обрабатываться несколько минут.
- Скачайте PDF с возможностью поиска и копирования текста.
- Загрузите этот новый PDF в инструмент «PDF в Word» и выполните преобразование в DOCX.
Режим повторного распознавания существующего текста стоит использовать, только если прежний текстовый слой распознан плохо: он удаляет старый результат и читает страницы заново. Режим обработки каждой страницы как изображения — крайний вариант, поскольку при нём теряются существующий выделяемый текст и ссылки.
После OCR вручную сверьте с изображением страницы даты, суммы, ИИН, номера договоров, реквизиты и фамилии. Именно в таких данных даже одна ошибка может быть критичной.
Почему после конвертации ломаются таблицы, шрифты и колонки?
Основная причина — PDF может визуально выглядеть как таблица или колонка, но внутри состоять из отдельных текстовых блоков и линий. Конвертеру приходится предполагать, какие элементы должны стать ячейками, абзацами и отступами.
Типичные причины и действия:
- Сложные таблицы. Объединённые ячейки, нестандартные границы и ширина столбцов иногда восстанавливаются неточно. Сначала проверьте ширину столбцов, перенос строк внутри ячеек и границы. Если ошибок много, таблицу может быть быстрее создать заново.
- Замена шрифта. Если шрифт из PDF не установлен на устройстве, Word выберет доступный аналог. У символов изменится ширина, из-за чего появятся новые переносы строк. Установите разрешённый шрифт или выберите единый доступный аналог, затем снова проверьте страницы.
- Колонки и текстовые блоки. Многоуровневая вёрстка может стать отдельными рамками, одной длинной колонкой или набором блоков. Исправляйте сначала структуру разделов, затем оформление.
- Изображения и подписи. Картинки с точным позиционированием могут сдвинуться, а подписи — оторваться от изображения. Проверьте параметры обтекания и привязку объектов.
- Нумерация и списки. Иногда номера и маркеры преобразуются в обычные символы. Если список должен продолжаться автоматически, примените встроенные стили нумерации Word.
Для договоров удобен такой порядок правок: сначала размер страницы, ориентация и поля; затем стили заголовков и абзацы; после этого разрывы страниц; в конце таблицы, колонтитулы и изображения. Ранняя коррекция таблиц часто оказывается напрасной, если позже меняется шрифт или ширина области текста.
Когда результат будет несовершенным и как безопасно обработать PDF?
Не стоит ожидать полностью готовой редактируемой копии без правок, если в документе есть рукописный текст, низкое разрешение скана, сложная сетка таблиц, редкие шрифты, множество печатей, формулы, много колонок или дизайнерская журнальная вёрстка. В отдельных случаях несколько страниц быстрее аккуратно собрать заново в Word, чем исправлять десятки смещений.
Если PDF подписан цифровой подписью, учитывайте важное ограничение OCR: после распознавания цифровая подпись больше не действительна, поскольку содержимое файла изменяется. Храните исходный подписанный PDF отдельно и используйте распознанную версию только как рабочую копию, если юридическая сила подписи важна.
Файлы для PDF Toucan передаются по HTTPS на серверы в Европейском союзе. Они обрабатываются в памяти, не записываются на диск и удаляются после скачивания результата, но не позднее чем через 10 минут. До загрузки всё равно проверьте, разрешают ли правила вашей компании, учреждения или договора использовать внешний онлайн-сервис для такого документа.
Почему Word открывает сканированный PDF как изображения?
Скан состоит из картинок страниц, а не из букв и абзацев. При прямом преобразовании такие страницы добавляются в DOCX как изображения, поэтому в них нельзя поставить курсор и исправить слово. Сначала обработайте файл OCR, затем конвертируйте получившийся PDF в Word.
Нужно ли сначала делать OCR, если текст в PDF выделяется?
Обычно не нужно. Если текст нормально выделяется, копируется и вставляется читаемыми словами, PDF уже содержит текстовый слой и готов к преобразованию. OCR полезен, когда текст не выделяется, копируется с явными ошибками или прежнее распознавание настолько плохое, что его требуется выполнить заново.
Какой язык выбрать в OCR для русско-казахского документа?
Выберите русский и казахский языки в одном запуске. Если в документе есть английские реквизиты, добавьте также английский, но не включайте ненужные языки: они замедляют обработку и могут ухудшить выбор похожих символов. После распознавания особенно тщательно проверьте имена, номера и суммы.
Почему после конвертации меняются шрифт и переносы строк?
Word может не найти шрифт, использованный в исходном PDF, и заменить его доступным аналогом с другой шириной символов. Даже небольшое отличие меняет переносы, высоту абзацев и разрывы страниц. Проверьте установленные шрифты, поля и межстрочные интервалы до настройки таблиц и изображений.
Похожие руководства
- Как сделать PDF с возможностью поиска текста: OCR без установкиПошагово рассказываем, как распознать скан PDF, выбрать русский и казахский языки, выровнять страницы, проверить текст и найти нужное слово.9 мин. чтения
- Ilovepdf или smallpdf: Лимиты, приватность и PDF ToucanСравниваем бесплатные лимиты, размер файлов, загрузку документов, водяные знаки и языки iLovePDF, Smallpdf и PDF Toucan.8 мин. чтения