Konvertere PDF til word gratis: Behold mest mulig formatering
PDF Toucan editorial team · Sist oppdatert 20. september 2026 · 8 min lesetid
Du kan konvertere PDF til Word gratis med PDF til Word: Velg filen, trykk «Konverter til Word» og last ned DOCX-filen. Digitale PDF-er med valgtbar tekst gir normalt best resultat. Skannede sider blir derimot lagt inn som bilder, så bruk OCR PDF først når du trenger søkbar og kopierbar tekst.
Hvorfor endres layouten når en PDF konverteres til Word?
En PDF er laget for å vise en ferdig side. Den lagrer hvor tekst, streker, bilder og andre elementer ligger på arket. Word fungerer annerledes: Dokumentet bygges av redigerbare avsnitt, stiler, tabeller, marger, sideskift og bilder som Word plasserer på nytt når filen åpnes.
En konvertering må derfor gjenskape strukturen bak en fast layout. Resultatet kan bli svært godt, men en helt identisk DOCX-fil er ikke alltid mulig. Dette er vanlige årsaker til at innhold flytter seg:
- Manglende skrifter: Hvis skrifttypen fra PDF-en ikke finnes på datamaskinen, erstatter Word den med en annen. Da endres ofte tegnbredde, linjeskift og sidetall.
- Tekstbokser og spalter: Elementer som visuelt ligger ved siden av hverandre, kan bli tolket som separate tekstområder eller som én lang tekstkolonne.
- Bilder og figurer: Bilder med tekst rundt seg kan få en annen plassering eller tekstbryting i Word.
- Sideformat og marger: Små forskjeller i papirstørrelse eller marger kan skyve én linje til neste side. Dette kan påvirke resten av dokumentet.
- Komplekse tabeller: Sammenslåtte celler, ulike kolonnebredder og tekst som er plassert visuelt i stedet for i faktiske celler trenger ofte kontroll.
En enkel, digitalt opprettet rapport, avtale eller brev er som regel et bedre utgangspunkt enn en brosjyre med mange grafiske elementer. Behandle derfor Word-filen som en redigerbar arbeidskopi, og behold original-PDF-en som fasit.
Hvordan konverterer du PDF til Word gratis?
Bruk denne arbeidsflyten når du kan markere tekst i PDF-en med musen. Det tyder normalt på at dokumentet allerede inneholder ekte tekst.
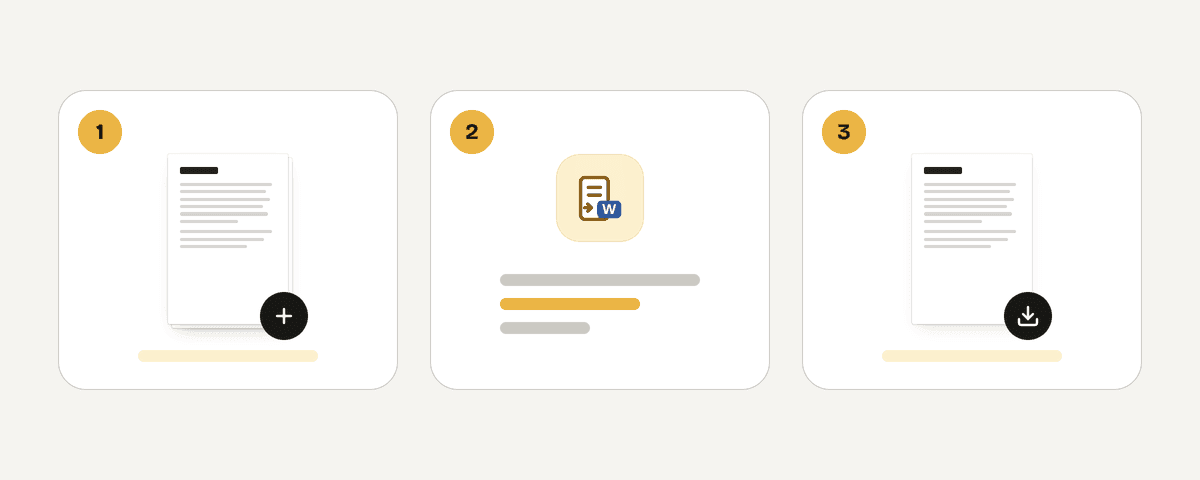
- Åpne PDF til Word-verktøyet.
- Velg «Velg PDF-filer».
- Velg PDF-en fra enheten. Du kan også dra filen hvor som helst på siden eller lime den inn.
- Legg eventuelt til flere PDF-er. Verktøyet kan behandle flere filer.
- Velg «Konverter til Word».
- Vent til dokumentet er klart, og velg nedlasting av Word-dokumentet.
- Åpne DOCX-filen i Microsoft Word, og sammenlign den med original-PDF-en før du begynner å redigere.
PDF Toucan krever ikke konto, legger ikke til vannmerke og har ingen daglig grense for verktøyene i nettleseren. Tjenesten finansieres av annonser. Filen sendes over HTTPS til servere i EU, behandles i minnet uten å bli skrevet til disk, og slettes når resultatet lastes ned, senest etter 10 minutter.
Hvis du senere trenger en fast sideutforming igjen, kan du bruke verktøyet word-to-PDF etter at redigeringen i Word er ferdig.
Hva gjør du hvis PDF-en er skannet?
Test først filen. Prøv å markere én setning i PDF-leseren og kopiere den. Hvis du ikke kan markere enkeltord, eller hele siden markeres som én flate, består dokumentet sannsynligvis av skannede bilder.
Dette er viktig fordi skannede sider ikke blir gjort om til tekst direkte i PDF til Word. De legges inn som bilder i Word-dokumentet. Dokumentet kan ligne originalen, men du kan ikke klikke i et avsnitt og endre ordene.
Når du trenger tekst som kan søkes i eller kopieres, gjør du dette først:
- Åpne OCR PDF.
- Velg «Velg PDF-filer», eller dra eller lim inn PDF-en.
- Under dokumentspråk velger du språket eller språkene som faktisk brukes i dokumentet.
- Velg «Gjenkjenn tekst».
- Når behandlingen er ferdig, last ned den søkbare PDF-en.
- Kontroller teksten, og konverter deretter den søkbare PDF-en til Word hvis du trenger en DOCX-fil.
Velg ikke flere språk enn nødvendig. Ekstra språk gjør tekstgjenkjenningen langsommere og kan gi et mindre presist utgangspunkt. OCR PDF gir en søkbar PDF, ikke en DOCX-fil, så kontroll og eventuell videre konvertering er fortsatt nødvendig.
Hvordan forbedrer du OCR-resultatet før du kopierer teksten?
OCR leser tegn i et sidebilde og prøver å gjøre dem om til maskinlesbar tekst. God skannekvalitet betyr mye, men valgene i OCR-verktøyet kan også hjelpe.
- Velg dokumentets riktige språk før du starter. Dette er særlig viktig for nordiske bokstaver, navn og ord med spesielle tegn.
- Bruk «Skann sider uten tekst» for vanlige skannede dokumenter. Dette er anbefalt innstilling og lar sider som allerede har tekst, være urørt.
- Velg «Gjenkjenn eksisterende tekst igjen» bare hvis PDF-en har gammel eller tydelig feilaktig tekstgjenkjenning. Det fjerner den gamle, dårlige teksten og leser sidene på nytt.
- Aktiver «Rett opp skjeve sider» når arksidene er skannet på skrå. Valget er ikke tilgjengelig når eksisterende tekst gjenkjennes på nytt.
- Aktiver automatisk korrigering av sideretning når enkelte sider er opp ned eller sidelengs.
- Unngå «Behandle hver side som et bilde» med mindre du må starte helt på nytt. Dette valget gjør hver side til et bilde før gjenkjenning og fjerner eksisterende valgtbar tekst og lenker.
Tekstgjenkjenning kan ta noen minutter for dokumenter med mange sider. Les resultatet side for side, og kontroller særlig navn, beløp, datoer, organisasjonsnummer og tallkolonner. Etter OCR er en digital signatur ikke lenger gyldig, fordi dokumentinnholdet er endret. Behold derfor originalfilen når signaturen må kunne verifiseres.
Hvordan retter du tabeller, skrifter og sideskift i Word?
Start med struktur og sideoppsett, ikke små detaljer. Hvis du endrer marger eller skrifter til slutt, kan du skape nye feil i tabeller og sideskift.
- Lagre en kopi. Behold den nedlastede DOCX-filen uendret, og rediger en kopi. Da kan du alltid sammenligne med den første konverteringen.
- Sjekk sideoppsett. Kontroller papirstørrelse, retning og marger mot PDF-en. Gjør dette før du bruker tid på avsnittsavstand og manuelle sideskift.
- Kontroller overskrifter og brudd. Sammenlign overskrifter, sidetall, fotnoter, avsnittsskift og sider som begynner eller slutter på feil sted.
- Bytt skrifter bevisst. Hvis Word har erstattet en skrift, velg en tilgjengelig skrifttype og gå deretter gjennom linjeskift, innrykk, linjeavstand og sidebrudd på nytt.
- Gå gjennom hver tabell. Klikk i tabellen og kontroller kolonnebredder, sammenslåtte celler, radhøyde, radskift over sider og tall som har havnet på feil linje.
- Bygg kompliserte tabeller på nytt ved behov. Når mange celler er feil, går det ofte raskere å lage en ny Word-tabell og lime inn kontrollert tekst enn å reparere konverteringen celle for celle.
- Kontroller bilder og bildetekster. Se spesielt etter tekst ved siden av bilder, flytende objekter og bilder som ligger bak tekst.
| Element i PDF-en | Typisk utfordring i Word | Praktisk løsning |
|---|---|---|
| Enkel brødtekst | Små endringer i linjeskift | Kontroller skrifttype, marger og linjeavstand |
| Tabell med sammenslåtte celler | Celler eller bredder flytter seg | Rett strukturen eller bygg tabellen på nytt |
| Flere spalter | Innhold blir tekstbokser eller én spalte | Gjenskap spalter og kontroller rekkefølgen |
| Skannet dokument | Teksten er et bilde | Kjør OCR og korrekturles resultatet |
| Brosjyre med grafikk | Objekter og tekst flytter seg | Bruk Word til innhold, ikke som visuelt arkiv |
Når bør du forvente at resultatet ikke blir perfekt?
Forvent ekstra opprydding når originalen har lav oppløsning, svake kontraster, håndskrift, stempler, notater eller skjeve sider. OCR kan forveksle tegn som 0 og O, eller 1 og l, spesielt i liten skrift og tette tallkolonner.
Avanserte dokumenter med mange spalter, grafiske brosjyreoppsett, diagrammer, skjemaer og tekst over bilder blir heller ikke alltid til vanlige, redigerbare Word-elementer. I slike tilfeller kan det være raskere å hente ut og korrekturlese teksten, og deretter bygge de viktigste delene på nytt i Word.
Hvis målet er at dokumentet skal se helt likt ut ved arkivering, utskrift eller deling, er PDF-en det riktige originalformatet. Bruk Word-versjonen når målet er å redigere innholdet. Ikke bruk den som eneste visuelle referanse uten å sammenligne med originalen.
Vanlige spørsmål
Er PDF til Word gratis å bruke?
Ja. Verktøyet krever ikke konto, legger ikke til vannmerke og har ingen daglig grense for bruk i nettleseren. Annonser finansierer tjenesten. Du kan legge til én eller flere PDF-filer, konvertere dem og laste ned Word-dokumentene når de er klare.
Blir en skannet PDF til redigerbar tekst i Word?
Ikke ved direkte konvertering. Skannede sider blir lagt til som bilder i Word-dokumentet, ikke som redigerbar tekst. Kjør først OCR for å få en søkbar PDF med kopierbar tekst, kontroller resultatet nøye og konverter deretter PDF-en til Word.
Hvordan gjør jeg en skannet PDF søkbar?
Åpne OCR PDF, velg «Velg PDF-filer», angi minst ett dokumentspråk og velg «Gjenkjenn tekst». Bruk «Skann sider uten tekst» for vanlige skanninger. Last deretter ned den søkbare PDF-en, og test at du kan søke etter og markere tekst.
Hvorfor flytter tabeller og skrifter seg etter konvertering?
PDF låser elementene til faste plasseringer, mens Word beregner plasseringen ut fra avsnitt, tabeller, stiler og tilgjengelige skrifter. En erstattet skrift eller litt endrede marger kan endre linjeskift og skyve resten av dokumentet videre, inkludert tabeller og sideskift.
Er filen min trygg når jeg bruker PDF Toucan?
Filen sendes over HTTPS og behandles på servere i EU. Den behandles i minnet, ikke skrevet til disk eller lagret, og slettes når du laster ned resultatet, senest etter 10 minutter. Vurder likevel alltid interne regler før du behandler fortrolige dokumenter.
Relaterte veiledninger
- OCR PDF gratis: Gjør skannede PDF-er søkbareGjør en skannet PDF søkbar med OCR: velg riktig språk, rett opp skjeve sider, kontroller teksten og bruk den videre i Word.8 min lesetid
- Slå sammen PDF gratis online: Sammenlign grenser og personvernSammenlign gratis PDF-verktøy på oppgaver, filgrenser, personvern, vannmerker og språk. Se når PDF Toucan passer best i Norge.8 min lesetid