PDF OCR online free: स्कैन PDF को खोजने योग्य बनाने का तरीका
PDF Toucan editorial team · अंतिम अपडेट 20 सितंबर 2026 · 8 मिनट पढ़ें
स्कैन की हुई फाइल के लिए PDF OCR online free तरीका यह है कि PDF Toucan के OCR PDF टूल में PDF चुनें, दस्तावेज़ की भाषा चुनें और “टेक्स्ट पहचानें” दबाएँ। इससे PDF में खोजने और कॉपी करने योग्य टेक्स्ट लेयर जुड़ती है। डाउनलोड की गई searchable PDF में नाम, नंबर और वाक्य खोजे जा सकते हैं; Word में काम करने से पहले परिणाम जाँचें।
OCR क्या करता है और स्कैन PDF में इसकी जरूरत क्यों पड़ती है?
स्कैन की हुई PDF अक्सर कागज़ के पन्नों की तस्वीरों का संग्रह होती है। देखने में उस पर शब्द साफ़ दिख सकते हैं, लेकिन PDF रीडर के लिए वे केवल पिक्सेल होते हैं। इसलिए Ctrl+F से कोई शब्द नहीं मिलता, वाक्य चुनने के बजाय पूरा चित्र चुनता है और कॉपी किया हुआ टेक्स्ट उपयोगी नहीं होता।
OCR का अर्थ Optical Character Recognition, यानी टेक्स्ट पहचान है। यह पन्ने की तस्वीर में अक्षरों के आकार पढ़ता है और मूल स्कैन के ऊपर एक अदृश्य, चुनने योग्य टेक्स्ट लेयर जोड़ता है। पेज का रूप सामान्यतः वही बना रहता है, पर आप शब्द खोज, कॉपी और टेक्स्ट एक्सट्रैक्ट कर सकते हैं।
ध्यान रखें कि searchable PDF और पूरी तरह संपादन योग्य Word दस्तावेज़ एक ही चीज़ नहीं हैं। OCR खोजने व कॉपी करने में मदद करता है, लेकिन जटिल लेआउट, तालिकाएँ, हस्तलिखित टिप्पणियाँ और फॉर्म के बॉक्स वैसे ही दिख सकते हैं। साफ़, सीधे और अच्छे प्रिंट वाले स्कैन में पहचान बेहतर रहती है; धुंधले, मुड़े, कम रोशनी वाले या बहुत छोटे अक्षरों में गलतियाँ संभव हैं।
PDF Toucan पर मुफ्त में PDF OCR कैसे चलाएँ?
यह प्रक्रिया डेस्कटॉप, टैबलेट और मोबाइल ब्राउज़र पर लगभग समान है। PDF Toucan के ब्राउज़र टूल के लिए अकाउंट, वॉटरमार्क या दैनिक सीमा नहीं है।
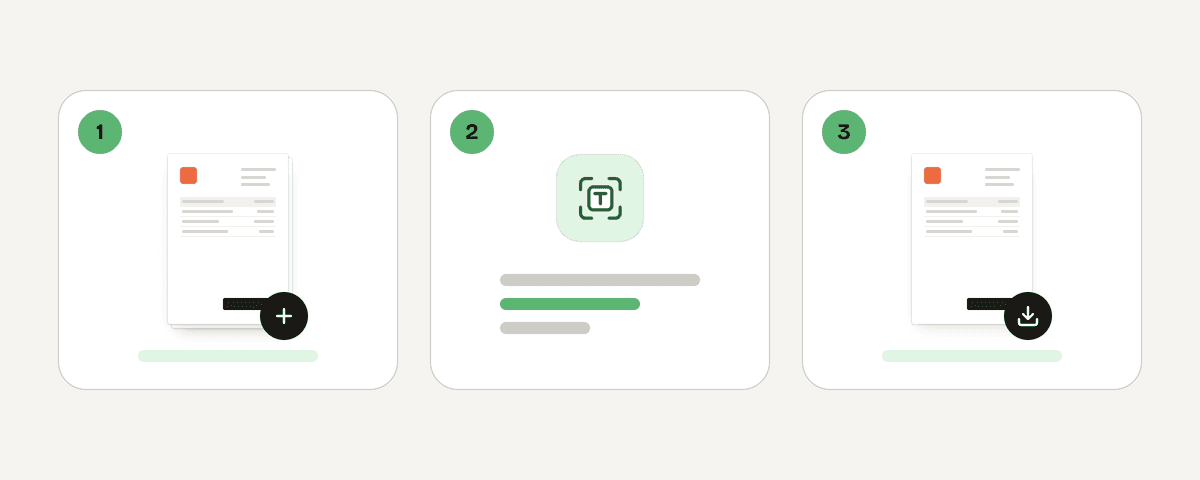
- OCR PDF पेज खोलें और “PDF फ़ाइलें चुनें” दबाएँ। PDF को पेज पर कहीं भी ड्रॉप किया जा सकता है या क्लिपबोर्ड से पेस्ट किया जा सकता है।
- एक PDF या कई PDF चुनें। कई फाइलें चुनने पर हर फाइल की पहचान अलग-अलग होती है।
- “दस्तावेज़ की भाषा” में कम-से-कम एक भाषा चुनें। फिर जरूरत हो तो “और विकल्प” खोलकर पेज और सुधार विकल्प सेट करें।
- “टेक्स्ट पहचानें” दबाएँ। बहुत अधिक पन्नों वाली PDF की टेक्स्ट पहचान में कुछ मिनट लग सकते हैं, इसलिए प्रक्रिया पूरी होने तक टैब खुला रखें।
- “टेक्स्ट पहचान लिया गया!” संदेश आने पर “खोजने योग्य PDF डाउनलोड करें” चुनें। अब परिणाम वाली PDF में टेक्स्ट खोजा और कॉपी किया जा सकता है।
पहले 5–10 पन्नों की एक छोटी फाइल से परिणाम जाँचना उपयोगी है, खासकर यदि आपके दस्तावेज़ में तालिकाएँ, टिकट, मुहरें या कई कॉलम हैं। इससे बड़े संग्रह पर समय लगाने से पहले सही भाषा और विकल्प का पता चल जाता है।
OCR के लिए हिंदी, अंग्रेज़ी और दूसरी भाषाएँ कैसे चुनें?
“दस्तावेज़ की भाषा” केवल डिस्प्ले की सेटिंग नहीं है। इससे OCR इंजन को पता चलता है कि उसे किन अक्षरों और शब्द-पैटर्न को पहचानना है। हिंदी के लिए देवनागरी भाषा चुनें; अंग्रेज़ी सामग्री के लिए English चुनें। दस्तावेज़ में जो भाषाएँ वास्तव में हैं, केवल वही चुनना सबसे अच्छा तरीका है।
| दस्तावेज़ का प्रकार | सुझाया भाषा चयन | कारण |
|---|---|---|
| केवल हिंदी पत्र या नोट्स | हिंदी | देवनागरी अक्षरों और मात्राओं पर बेहतर फोकस रहता है |
| केवल अंग्रेज़ी रिपोर्ट | English | अनावश्यक भाषाएँ प्रक्रिया धीमी नहीं करेंगी |
| हिंदी-अंग्रेज़ी स्कूल दस्तावेज़ | हिंदी + English | दोनों लिपियों और शब्दों की पहचान होती है |
| द्विभाषी आवेदन या संदर्भ पत्र | वास्तव में मौजूद दोनों भाषाएँ | नाम, निर्देश और विवरण खोजने में मदद मिलती है |
एक रन में अधिकतम 5 भाषाएँ मिलाई जा सकती हैं। फिर भी “शायद जरूरत पड़ जाए” सोचकर बहुत-सी भाषाएँ न चुनें: अतिरिक्त भाषाएँ पहचान को धीमा करती हैं और कुछ अक्षरों के गलत विकल्प बढ़ा सकती हैं। उदाहरण के लिए, हिंदी-अंग्रेज़ी मिश्रित आधार-संबंधी पत्र में दोनों चुनें, लेकिन केवल हिंदी सामग्री में सिर्फ हिंदी चुनें। टूल देवनागरी सहित लैटिन, सिरिलिक, ग्रीक, अरबी, हिब्रू, थाई, चीनी, जापानी और कोरियाई लिपियों समेत 30 पहचान भाषाओं का समर्थन करता है।
टेढ़े, उल्टे या पहले से टेक्स्ट वाले पन्नों के लिए कौन-सा विकल्प चुनें?
“और विकल्प” में पेज स्कैन और सुधार विकल्प मिलते हैं। सही विकल्प से बेहतर परिणाम मिल सकता है, लेकिन सभी विकल्प हर स्थिति में जरूरी नहीं हैं।
| विकल्प | यह क्या करता है | कब चुनें | ध्यान रखने वाली बात |
|---|---|---|---|
| “बिना टेक्स्ट वाले पेज स्कैन करें” | केवल ऐसे पन्ने पढ़ता है जिनमें टेक्स्ट नहीं है | सामान्य स्कैन या मिश्रित PDF | यह अनुशंसित विकल्प है; पहले से टेक्स्ट वाले पन्ने वैसे ही रहते हैं |
| “मौजूदा टेक्स्ट फिर पहचानें” | खराब पुराने टेक्स्ट को हटाकर फिर पहचानता है | खोज या कॉपी में पुराना टेक्स्ट गलत निकलता हो | इस मोड में पन्ना सीधा करने का विकल्प उपलब्ध नहीं है |
| “हर पेज को चित्र मानें” | हर पन्ने को चित्र बनाकर शुरू से पढ़ता है | मौजूदा टेक्स्ट लेयर बहुत खराब या अनुपयोगी हो | पुराना selectable text और लिंक हट जाते हैं |
| “टेढ़े पेज सीधे करें” | हल्के तिरछे स्कैन सीधे करता है | मोबाइल कैमरा या तिरछे स्कैन | “मौजूदा टेक्स्ट फिर पहचानें” के साथ उपलब्ध नहीं |
| “पेज दिशा अपने-आप ठीक करें” | उल्टे या साइडवेज़ पन्नों को सही दिशा में करता है | उल्टे, लैंडस्केप या गलत घूमे पन्ने | परिणाम डाउनलोड करने से पहले कुछ पन्ने जाँचें |
अधिकांश मामलों में “बिना टेक्स्ट वाले पेज स्कैन करें” से शुरुआत करें। यह उन पन्नों को छोड़ देता है जिनमें पहले ही सही टेक्स्ट मौजूद है। यदि पेज थोड़ा तिरछा है, “टेढ़े पेज सीधे करें” चालू करें। अगर स्कैन उल्टा या 90 डिग्री घूम गया है, “पेज दिशा अपने-आप ठीक करें” चुनें।
“मौजूदा टेक्स्ट फिर पहचानें” तब चुनें जब PDF में टेक्स्ट चुनने योग्य तो है, पर खोजने पर शब्द नहीं मिलता या कॉपी करने पर बेकार अक्षर आते हैं। यदि उसी फाइल में तिरछापन भी है, तो विकल्प की सीमा समझें: इस मोड में सीधा करने की सुविधा नहीं मिलती। केवल स्पष्ट जरूरत पर “हर पेज को चित्र मानें” चुनें, क्योंकि इससे पुराने लिंक और चुनने योग्य टेक्स्ट मिट जाते हैं।
OCR के बाद टेक्स्ट सही है या नहीं, कैसे जाँचें और PDF में खोजें?
OCR पूरा होने पर केवल सफलता संदेश देखकर न रुकें। कुछ मिनट की जाँच महत्वपूर्ण जानकारी में गलतियों से बचाती है।
- डाउनलोड की गई searchable PDF को Chrome, Adobe Acrobat Reader या फोन के सामान्य PDF viewer में खोलें।
- Windows या ChromeOS पर Ctrl+F दबाएँ; Mac पर Command+F दबाएँ। फोन में खोज आइकन खोलें।
- ऐसा नाम, पता, तारीख, इनवॉइस नंबर या खास शब्द खोजें जो पन्ने पर साफ़ दिख रहा हो। देखें कि viewer सही पेज पर पहुँचता है या नहीं।
- शुरुआत, बीच और अंत के अलग-अलग पन्नों पर यही जाँच दोहराएँ। पूरी फाइल में गुणवत्ता एक जैसी होना जरूरी नहीं है।
- एक छोटा वाक्य चुनकर कॉपी करें और Notes या किसी plain-text ऐप में पेस्ट करें। मूल स्कैन से मिलान करें।
खास तौर पर टूटे अक्षर, गलत मात्राएँ, नाम, पते, रकम, तारीख और 0/O, 1/l, 5/S जैसे मिलते-जुलते चिह्न जाँचें। कम रोशनी, फीका प्रिंट, मुड़ा पन्ना, मुहर और बहुत छोटी लिखावट OCR को कठिन बनाते हैं। कानूनी, बैंकिंग, परीक्षा या पहचान-संबंधी दस्तावेज़ में मूल स्कैन से अनिवार्य रूप से मिलान करें।
यदि PDF में डिजिटल हस्ताक्षर है, तो OCR करने पर वह हस्ताक्षर वैध नहीं रहता। हस्ताक्षरित मूल PDF को बिना बदले सुरक्षित रखें और searchable कॉपी को केवल खोज, कॉपी या कामकाजी संदर्भ के लिए इस्तेमाल करें।
OCR के बाद Word में कैसे काम करें?
यदि आपको टेक्स्ट संपादित करना है, तो क्रम सही रखें: पहले OCR, फिर Word कन्वर्ज़न। सीधे scanned PDF को Word में बदलने से संपादन योग्य टेक्स्ट मिलने की गारंटी नहीं है।
- पहले OCR की गई searchable PDF डाउनलोड करें और उसमें कुछ शब्द खोजकर जाँच लें।
- PDF से Word टूल खोलें और “PDF फ़ाइलें चुनें” दबाकर OCR के बाद वाली PDF चुनें।
- “Word में बदलें” चुनें और तैयार होने पर Word दस्तावेज़ डाउनलोड करें।
- DOCX को Word में खोलें। मूल searchable PDF को साथ में रखकर शीर्षक, पैराग्राफ, तालिका, तारीख और नाम जाँचें।
महत्वपूर्ण सीमा यह है कि PDF से Word टूल scanned pages को स्वयं टेक्स्ट में नहीं पहचानता; ऐसे पन्ने DOCX में चित्रों के रूप में जोड़े जाते हैं। इसलिए मूल स्कैन को सीधे DOCX बनाने पर आपको पेज-चित्र मिल सकते हैं, संपादन योग्य पैराग्राफ नहीं। OCR के बाद कन्वर्ट करने पर Word के पास पढ़ने योग्य टेक्स्ट होता है, फिर भी जटिल तालिकाएँ, कई कॉलम और फॉर्म को हाथ से ठीक करना पड़ सकता है। बड़ी image-heavy फाइल के आकार को बाद में कम करने के लिए साइट का compress टूल उपयोगी हो सकता है।
फाइल की गोपनीयता और प्रोसेसिंग के बारे में क्या जानें?
OCR एक सर्वर-आधारित प्रक्रिया है। फाइल HTTPS के जरिए यूरोपीय संघ के सर्वर पर भेजी जाती है, मेमोरी में प्रोसेस होती है और डिस्क पर लिखी या संग्रहीत नहीं की जाती। परिणाम डाउनलोड होते ही फाइल हटा दी जाती है; यदि डाउनलोड न भी हो, तो अधिकतम 10 मिनट के भीतर हटा दी जाती है।
फिर भी गोपनीयता का निर्णय आपकी स्थिति पर निर्भर है। पासवर्ड, बैंक विवरण, चिकित्सा रिकॉर्ड, गोपनीय कंपनी दस्तावेज़ या अत्यंत संवेदनशील पहचान पत्र पर काम करने से पहले अपनी संस्था की नीति, कानूनी जरूरत और अनुमति जाँचें। यदि कोई फाइल आपके डिवाइस से बाहर नहीं जानी चाहिए, तो स्थानीय या ऑफलाइन सॉफ़्टवेयर अपनाना अधिक उपयुक्त हो सकता है।
अक्सर पूछे जाने वाले सवाल
क्या PDF OCR online free से हिंदी PDF में टेक्स्ट खोजा जा सकता है?
हाँ। स्कैन PDF चुनें, “दस्तावेज़ की भाषा” में हिंदी चुनें और “टेक्स्ट पहचानें” दबाएँ। डाउनलोड की searchable PDF में देवनागरी शब्द खोजे और कॉपी किए जा सकते हैं। धुंधले स्कैन, हस्तलिखित टेक्स्ट और गलत मात्राओं के लिए परिणाम को मूल पन्ने से जाँचें।
OCR के लिए हिंदी और अंग्रेज़ी दोनों भाषाएँ चुननी चाहिए क्या?
केवल तब, जब दस्तावेज़ में दोनों भाषाएँ मौजूद हों। हिंदी-अंग्रेज़ी मिश्रित नोट्स, आवेदन या स्कूल दस्तावेज़ में दोनों चुनें। केवल हिंदी फाइल में सिर्फ हिंदी चुनना बेहतर है। अनावश्यक अतिरिक्त भाषाएँ प्रक्रिया धीमी कर सकती हैं और पहचान में विचित्र बदलाव ला सकती हैं।
टेढ़े या उल्टे स्कैन किए पन्नों को OCR से कैसे ठीक करें?
“और विकल्प” में तिरछे पन्नों के लिए “टेढ़े पेज सीधे करें” और उल्टे या साइडवेज़ पन्नों के लिए “पेज दिशा अपने-आप ठीक करें” चुनें। परिणाम के कुछ पन्ने खोलकर दिशा और खोज की जाँच करें। ध्यान दें कि “मौजूदा टेक्स्ट फिर पहचानें” मोड में सीधा करने का विकल्प उपलब्ध नहीं होता।
क्या OCR के बाद PDF को Word में बदलने पर पूरा टेक्स्ट संपादित हो जाएगा?
पहले OCR चलाने से संपादन योग्य सामग्री मिलने की संभावना बढ़ती है, लेकिन पूर्ण लेआउट-सटीकता की गारंटी नहीं है। scanned PDF को सीधे Word में बदलने पर पन्ने चित्र बन सकते हैं। OCR वाली PDF को फिर Word में बदलें और तालिकाएँ, कॉलम, नाम, नंबर तथा फॉर्मैट मूल PDF से मिलाकर ठीक करें।